Domain umwelt-buch.de kaufen?
Wir ziehen mit dem Projekt
umwelt-buch.de um.
Sind Sie am Kauf der Domain
umwelt-buch.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain umwelt-buch.de kaufen?
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **


Ähnliche Suchbegriffe für Springer-Neural-Text-to-Speech-Synthesis
Top-Angebote
Produkte zum Begriff Springer-Neural-Text-to-Speech-Synthesis:
-
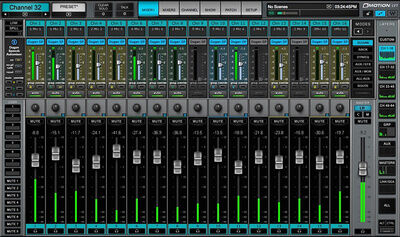
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Neural DSP Quad CortexNeural DSP Quad Cortex; Multi-Effektpedal für E-Gitarre & Bass; Extrem leistungsstarke und kompakte Bodeneinheit mit 2GHz dedizierter DSP aus der Quad-Core SHARC® Architektur; Superior Modeling Technology: Eine ständig wachsende Sammlung von Algorithmen mit kompromissloser Klangqualität, sehr niedriger Latenz und beispiellose routing Flexibilität; Neural Capture: eine einzigartige neuronale Netzwerk Architektur die in der Lage ist, ähnlich wie die Menschliche Wahrnehmung den Klang und die Dynamik eines Verstärkers selbstständig zu analysieren, zu lernen und, nachzubilden einschließlich einer ständig wachsenden Sammlung kostenloser, Custom Rig-Captures von einigen der besten Produzenten und Sound Designer; 7"-Multi-Touch-Display für intuitive Bedienung; Cabsim mit über 1000 perfekt erfassten Impulsantworten, Elf eigens entwickelte Kombi Fußschalter & Drehregler; integriertes Wifi für das Teilen von rig-Captures, Presets, Backups sowie Firmware-Updates, neben anderen einzigartigen Funktionen; Regler: Volume, 11 x Combi Footswitches/Rotary Controls; Fußschalter: 11 x Combi Footswitches/Rotary Controls; Anschlüsse: Input 1 & 2 (Combi XLR/Klinke), FX Loop 1 (2 x 6,3 mm Klinke), FX Loop 2 (2 x 6,3 mm Klinke), Out 1 & 2 (2 x XLR), Out 3 & 4 (2 x 6,3 mm Stereoklinke), Headphone Out (6,3 mm Stereoklinke), Expression 1 & 2 (2 x 6,3 mm Stereoklinke), MIDI In & Thru/Out, USB; Netzadapter Anschluss: Hohlstecker Buchse 5,5 x 2,1 mm, Minuspol Innen; Stromversorgung mit einem 12 V DC Netzadapter (im Lieferumfang enthalten); kein Batteriebetrieb; Abmessungen (B x T x H): 290 x 191 x 48 mm; Gewicht: 1,98 kg1669,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann man die JavaScript-Speech-Synthesis verbessern?
Um die JavaScript-Speech-Synthesis zu verbessern, könnten Sie zunächst sicherstellen, dass Sie die neueste Version des Browsers verwenden, da ältere Versionen möglicherweise nicht alle Funktionen unterstützen. Darüber hinaus könnten Sie verschiedene Sprachsynthese-APIs ausprobieren, um die beste Qualität und Genauigkeit der Sprachausgabe zu erzielen. Schließlich könnten Sie auch benutzerdefinierte Wörterbücher oder Ausspracheanweisungen verwenden, um spezifische Wörter oder Phrasen korrekt auszusprechen. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **

Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Top-Angebote
Produkte zum Begriff Springer-Neural-Text-to-Speech-Synthesis:
-
Schönwandt, A: Glättung von F0-Konturen in Text-To-Speech Sy, Taschenbuch von Anne Schönwandt, VDM, 978-3-639-26029-8Schönwandt, A: Glättung Von F0-konturen In Text-to-speech Sy, Taschenbuch Von Anne Schönwandt, Vdm, 978-3-639-26029-8, Seitenanzahl: 9649,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer599,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Krause, Benjamin: Hate SpeechHate Speech , Strafbarkeit und Strafverfolgung von Hasspostings , Scheinwerfer-Vorschaltgeräte & Zündgeräte > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20221021, Produktform: Kartoniert, Autoren: Krause, Benjamin, Auflage: 22001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 114, Keyword: Hasskriminalität; Silencing; Radikalisierung, Fachschema: International (Recht)~Internationales Recht~Strafrecht, Fachkategorie: Strafrecht, allgemein, Warengruppe: TB/Strafrecht, Fachkategorie: Internationales Öffentliches Recht: Strafrecht, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: XII, Seitenanzahl: 114, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: C.H. Beck, Verlag: C.H. Beck, Verlag: Verlag C.H. Beck oHG, Länge: 236, Breite: 157, Höhe: 12, Gewicht: 252, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Wie kann man die JavaScript-Speech-Synthesis verbessern?
Um die JavaScript-Speech-Synthesis zu verbessern, könnten Sie zunächst sicherstellen, dass Sie die neueste Version des Browsers verwenden, da ältere Versionen möglicherweise nicht alle Funktionen unterstützen. Darüber hinaus könnten Sie verschiedene Sprachsynthese-APIs ausprobieren, um die beste Qualität und Genauigkeit der Sprachausgabe zu erzielen. Schließlich könnten Sie auch benutzerdefinierte Wörterbücher oder Ausspracheanweisungen verwenden, um spezifische Wörter oder Phrasen korrekt auszusprechen. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Springer-Neural-Text-to-Speech-Synthesis
-
Neural DSP Quad CortexNeural DSP Quad Cortex; Multi-Effektpedal für E-Gitarre & Bass; Extrem leistungsstarke und kompakte Bodeneinheit mit 2GHz dedizierter DSP aus der Quad-Core SHARC® Architektur; Superior Modeling Technology: Eine ständig wachsende Sammlung von Algorithmen mit kompromissloser Klangqualität, sehr niedriger Latenz und beispiellose routing Flexibilität; Neural Capture: eine einzigartige neuronale Netzwerk Architektur die in der Lage ist, ähnlich wie die Menschliche Wahrnehmung den Klang und die Dynamik eines Verstärkers selbstständig zu analysieren, zu lernen und, nachzubilden einschließlich einer ständig wachsenden Sammlung kostenloser, Custom Rig-Captures von einigen der besten Produzenten und Sound Designer; 7"-Multi-Touch-Display für intuitive Bedienung; Cabsim mit über 1000 perfekt erfassten Impulsantworten, Elf eigens entwickelte Kombi Fußschalter & Drehregler; integriertes Wifi für das Teilen von rig-Captures, Presets, Backups sowie Firmware-Updates, neben anderen einzigartigen Funktionen; Regler: Volume, 11 x Combi Footswitches/Rotary Controls; Fußschalter: 11 x Combi Footswitches/Rotary Controls; Anschlüsse: Input 1 & 2 (Combi XLR/Klinke), FX Loop 1 (2 x 6,3 mm Klinke), FX Loop 2 (2 x 6,3 mm Klinke), Out 1 & 2 (2 x XLR), Out 3 & 4 (2 x 6,3 mm Stereoklinke), Headphone Out (6,3 mm Stereoklinke), Expression 1 & 2 (2 x 6,3 mm Stereoklinke), MIDI In & Thru/Out, USB; Netzadapter Anschluss: Hohlstecker Buchse 5,5 x 2,1 mm, Minuspol Innen; Stromversorgung mit einem 12 V DC Netzadapter (im Lieferumfang enthalten); kein Batteriebetrieb; Abmessungen (B x T x H): 290 x 191 x 48 mm; Gewicht: 1,98 kg1669,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
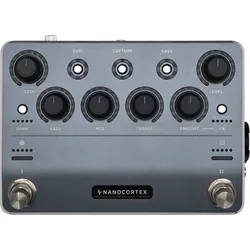
Neural DSP Nano CortexNeural-Capture-Technologie mit der gleichen Auflösung und Qualität wie bei Quad Cortex, Unglaublich genaue digitale Nachbildungen jedes Verstärkers, jeder Box oder jedes Drive-Pedals, Freier Zugriff auf Tausende von Neural Captures in der Cortex Cloud, Impulse Response Loader, Adaptive Noise Gate und Transpose-Funktion, Input Gate sowie 47 Effekte und Tools, Pre- und Post-FX Blöcke frei belegbar,569,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
-
Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.